DeepSeek进一步开放大模型推理基础设施。
继开源大模型、TileLang编译工具及一系列推理算子库后,DeepSeek宣布全面开源内部推理框架DeepInfer,并同步开源Token编解码组件deepseek-recipe,旨在帮助开发者和企业优化大规模模型部署,降低AI服务的算力成本与能源消耗。
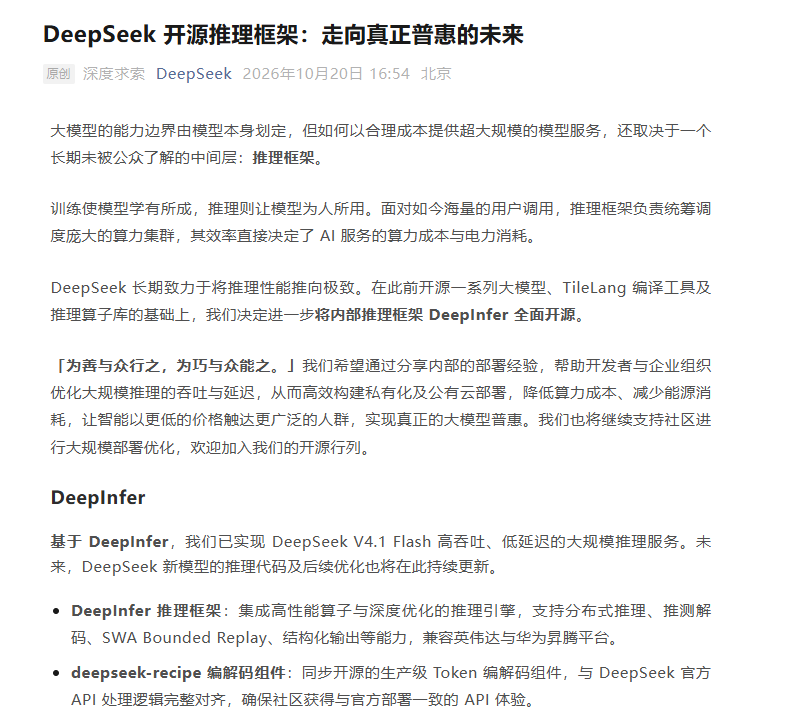
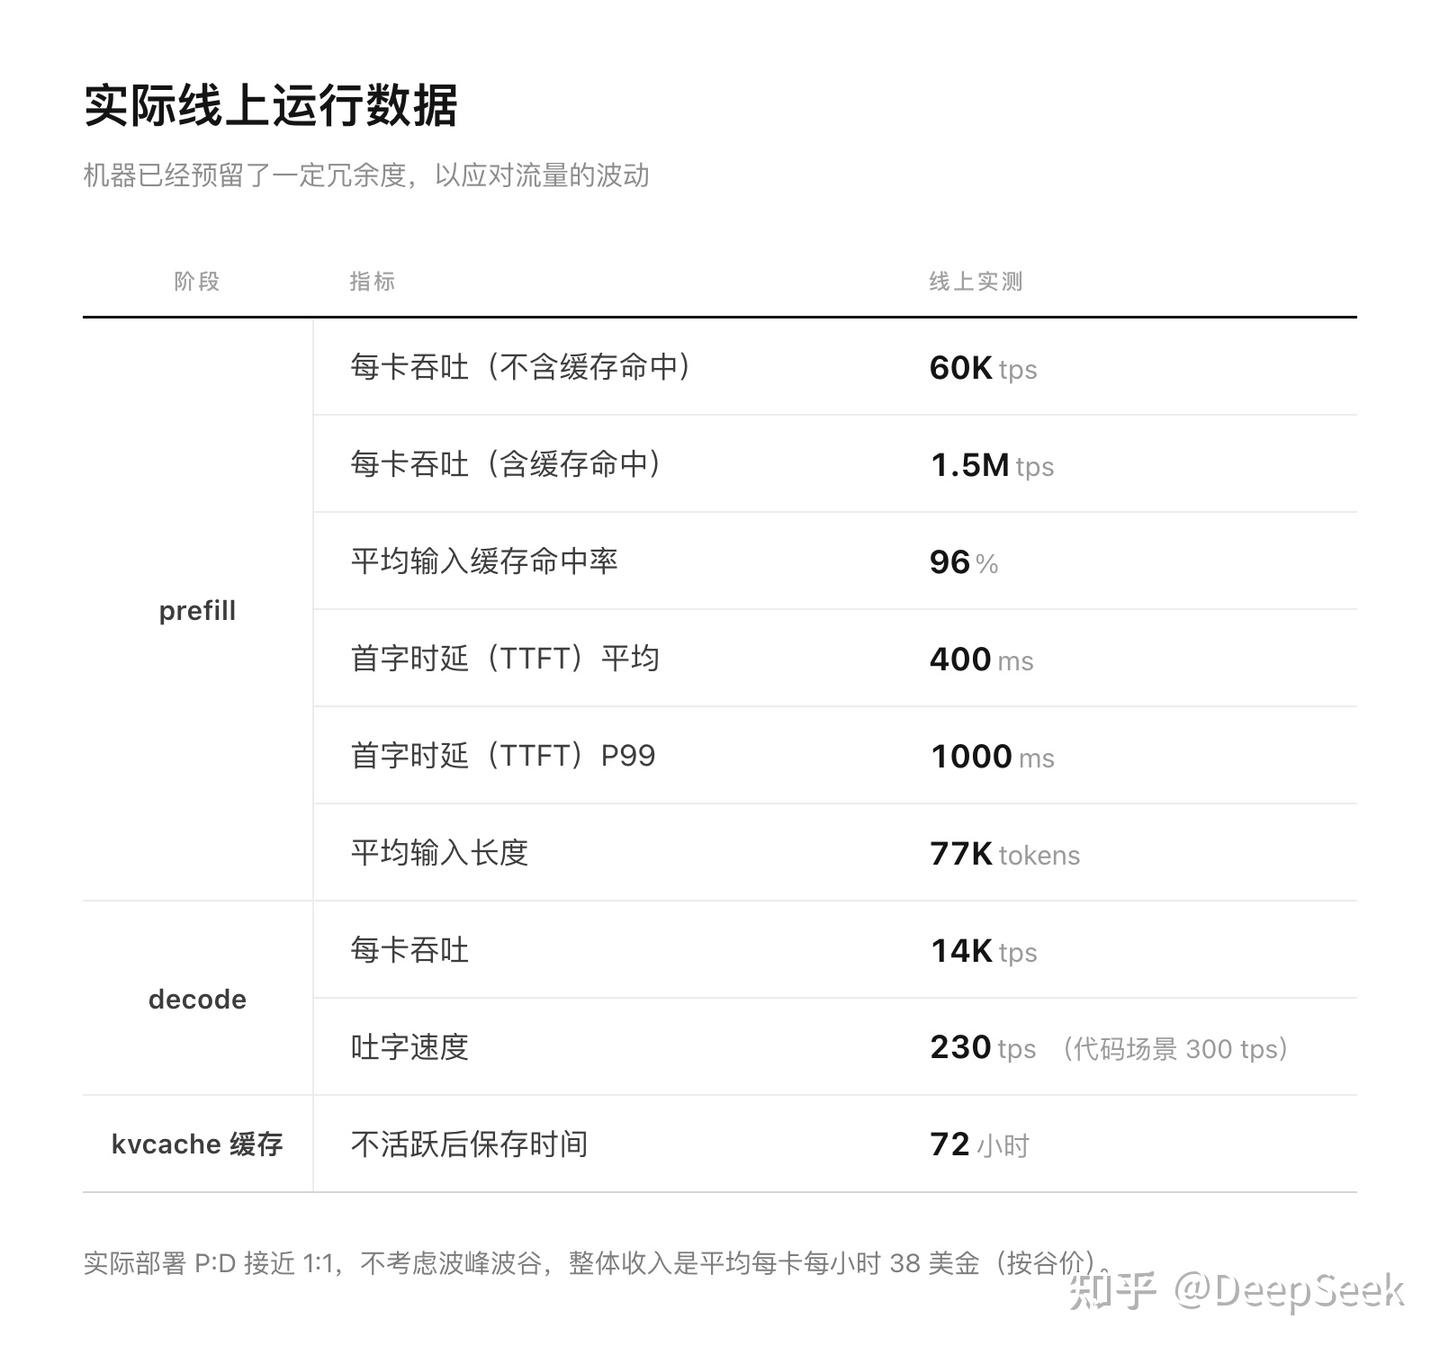
DeepSeek介绍,基于DeepInfer,团队已实现DeepSeek V4.1 Flash的高吞吐、低延迟大规模推理服务。目前,单一集群的服务吞吐量达到每天155万亿Token,按谷电价计算,每卡每小时收入为38美元。
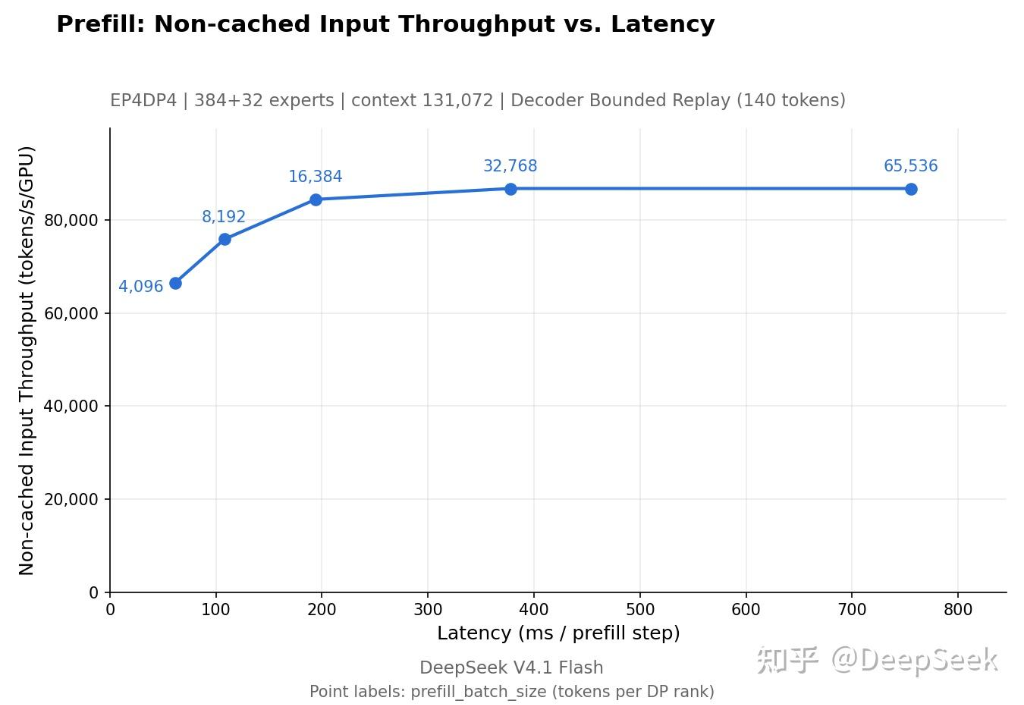
推理框架是连接大模型能力与终端用户的关键基础设施。随着AI应用调用量增长,推理服务的成本不仅取决于模型本身,还受到计算、通信、任务调度及缓存管理等环节的影响。如何在满足延迟要求的同时提高有效吞吐,已成为大规模AI服务降本增效的重要环节。
兼容英伟达与华为昇腾,针对不同推理阶段优化算力配置
DeepInfer集成高性能算子与深度优化的推理引擎,支持分布式推理、推测解码、SWA Bounded Replay及结构化输出等能力,可在英伟达与华为昇腾平台运行。未来,DeepSeek新模型的推理代码及后续性能优化也将在该框架中持续开源。
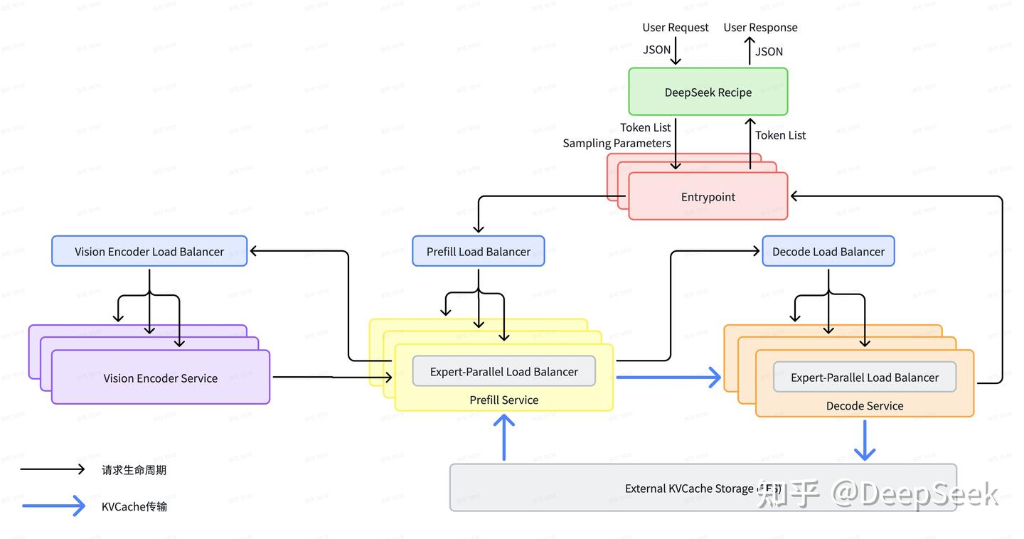
面对大规模AI调用需求,DeepSeek将推理系统的优化重点放在吞吐量与延迟上。系统采用Prefill与Decode分离部署:前者负责处理输入提示词,后者负责逐步生成Token。由于两个阶段的计算负载不同,分开部署可以独立配置资源,分别优化首个Token生成时间和后续Token生成间隔。
在硬件组织上,DeepSeek使用常见的8卡机器承担Prefill任务,并采用64至128卡超节点承担Decode任务。同时,系统通过自动扩缩容动态调整两个阶段的实例比例,减少流量变化导致的资源错配;在MoE模型推理中,则通过专家并行与动态负载均衡,降低不同计算卡之间的负载差异。
KVCache最长保留7天,减少重复计算开销
缓存复用是DeepSeek降低推理成本的另一项关键设计。随着长上下文对话和AI Agent应用增多,相同前缀可能在不同请求中反复出现。如果每次都重新处理这些内容,就会产生额外的计算开销。
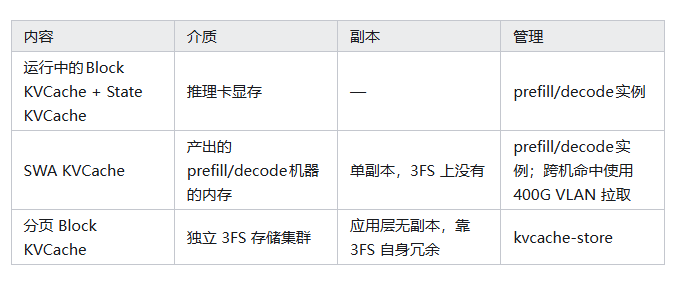
DeepSeek V4.1 Flash将KVCache分为Block KVCache和SWA KVCache两部分,采用不同的存储策略。其中,Block KVCache存储在独立的3FS分布式文件系统中,相关存储容量约为100 PiB。根据DeepSeek披露的数据,Agent流量的KVCache保留时间达到3天,聊天机器人流量则达到7天。
当后续请求命中已有缓存时,系统可以复用此前的计算结果,减少重复的Prefill计算。DeepSeek披露,3FS存储集群的峰值聚合读取带宽达到10 TiB/s,峰值聚合写入带宽约为850 GiB/s,以满足大规模缓存读写需求。
对于主要在活跃会话内短期复用的SWA KVCache,DeepSeek则选择保留在机器内存中,不进行持久化存储。线上数据显示,这部分缓存的保留时间约为180秒,命中率超过98%。
针对SWA KVCache未命中的情况,DeepSeek采用SWA Bounded Replay机制,仅重算最近128个Token,并将注意力窗口限制在重算区间内,以降低缓存缺失带来的额外计算成本。
投机解码提升吞吐,编解码组件同步开源
除缓存复用外,DeepSeek还通过投机解码和异步调度提高推理效率。
DeepSeek采用DSpark投机解码框架,根据候选Token的预期接受概率动态决定验证范围,避免将验证算力浪费在低接受概率的候选结果上。DeepSeek披露,在线部署中,与固定验证5个Token的方式相比,变长验证使吞吐提升6%。
在调度环节,系统通过CPU与GPU之间的异步协作,让请求调度、前向计算和采样等操作尽可能重叠,减少设备等待时间。此外,DeepInfer支持结构化输出,可依据JSON Schema、正则表达式等约束控制模型生成结果,满足特定应用对输出格式的要求。
DeepSeek还同步开源生产级Token编解码组件deepseek-recipe。该组件支持Chat Completions API、Responses API和Messages API等主流接口,并通过特殊Token边界识别、普通文本分段并行编码及流式输出解析等机制,提升长文本处理效率,确保第三方部署的API处理逻辑与官方服务保持一致。
不过,DeepSeek并未开放推理系统的全部组件。由于KVCache管理和负载均衡部分与内部基础设施耦合较深,相关代码目前尚未完整开源。
从模型、算子库到大规模推理框架,DeepSeek此次进一步扩展了开源技术栈的覆盖范围。对于开发者和企业而言,这有望降低构建私有化及公有云AI服务的技术门槛;对于大模型行业而言,如何提高推理吞吐、复用计算结果并适配不同硬件平台,也正成为控制AI服务成本的重要方向。
本文来自华尔街见闻,欢迎下载APP查看更多